728x90
반응형

핵심 차이

  • Pinecone → 완전 관리형 클라우드, 빠르게 쓰고 싶을 때
  • ChromaDB → 로컬 개발/프로토타이핑, 가장 쉬움
  • pgvector → 이미 PostgreSQL 쓰고 있으면 추가 인프라 없이 바로 가능---

언제 뭘 써야 하냐면:

  • 빠르게 RAG 앱 프로토타이핑 → ChromaDB로 시작
  • 프로덕션에 올리고 인프라 신경 쓰기 싫음 → Pinecone
  • 이미 PostgreSQL로 유저/상품 데이터 관리 중이고, 벡터 검색 결과를 그 데이터랑 같이 쓰고 싶음 → pgvector (SQL JOIN이 진짜 강점)

비교

호스팅 클라우드 전용 로컬 or 자체 서버 자체 서버 / RDS 등
설치 난이도 매우 쉬움 (API 키만) 매우 쉬움 (pip 한 줄) 중간 (PG 확장 설치)
성능 매우 빠름 (ANN) 중간 (소규모 충분) 중간 (HNSW 인덱스)
확장성 자동 스케일링 제한적 PG 스케일링 따름
비용 유료 (무료 티어 有) 무료 무료 (인프라만)
메타데이터 필터링 지원 where 절 지원 SQL 풀 지원
언어 지원 Python, JS, Go Python, JS 모든 PG 드라이버
장점 인프라 관리 불필요, 대규모 트래픽에 강함 LangChain 연동 쉬움, in-memory 테스트 가능 기존 DB와 JOIN 가능, 별도 인프라 없음
단점 벤더 종속, 비용 증가 가능 프로덕션 대규모엔 부적합 순수 벡터 DB보단 검색 느림


실제 개발 흐름은 ChromaDB로 개발 → Pinecone이나 pgvector로 프로덕션 전환하는 경우가 많아.

728x90
반응형
728x90
반응형

1. 토크나이징 (Tokenization)

먼저 텍스트를 토큰 단위로 쪼갬.

"안녕하세요 반갑습니다"
→ ["안녕", "##하세요", "반갑", "##습니다"]  ← BPE/WordPiece 방식

한글은 영어보다 형태소가 복잡해서, 글자 단위나 음절 단위로 쪼개는 경우도 많아.


2. 토큰 → 벡터 매핑 

각 토큰은 모델 내부의 임베딩 테이블(lookup table) 에서 고정된 초기 벡터로 변환돼.

"안녕" → [0.23, -0.11, 0.87, ...]  (768차원 등)
"반갑" → [0.41,  0.03, 0.12, ...]

이건 네가 말한 "단어 매핑"이랑 거의 같아.


3. Transformer로 문맥 반영 (핵심 차이점!)

근데 여기서 끝이 아니야. 각 토큰 벡터가 주변 문맥을 보면서 서로 영향을 주고받아 (Self-Attention).

"사과가 맛있다"  → "사과" 벡터가 과일 방향으로
"사과드립니다"   → "사과" 벡터가 사죄 방향으로

같은 단어도 문맥에 따라 다른 벡터가 됨.


4. 문서 전체를 하나의 벡터로 압축

마지막으로 모든 토큰 벡터를 하나의 벡터로 풀링해서 문서 전체의 의미를 표현.

[CLS] 토큰 사용 또는 평균 풀링
→ 최종 문서 벡터: [0.15, 0.72, -0.33, ...]  (1536차원 등)

정리하면

단계 하는 일

토크나이징 텍스트 → 토큰 조각
임베딩 테이블 토큰 → 초기 벡터 (네 말한 매핑!)
Transformer 문맥 반영해서 벡터 보정
풀링 전체를 하나의 벡터로 압축

결국 벡터디비에 들어가는 건 "이 문서의 의미 전체를 압축한 좌표" 같은 거야. 검색할 때 쿼리도 같은 과정으로 벡터화해서, 벡터 공간에서 가까운 문서를 찾는 방식이지.

728x90
반응형
728x90
반응형

하나의 Controller 메소드 안에서 Service를 여러 개 호출 할 때,
일부는 @Transactional 가 있고, 일부는 없으면 어떻게 될까?


각각 독립된 트랜잭션으로 동작해요!

Controller에 @Transactional이 없으면, 묶어줄 부모 트랜잭션이 없으니까 Service들이 각자 자기 트랜잭션을 생성하고 끝내요.

Controller (트랜잭션 없음)
    │
    ├─→ ServiceA @Transactional  → 트랜잭션 A 시작 → 커밋 ✅ (완전히 끝남)
    │
    ├─→ ServiceB @Transactional  → 트랜잭션 B 시작 → 커밋 ✅ (완전히 끝남)
    │
    └─→ ServiceC (없음)          → 그냥 실행 (트랜잭션 없이)

문제가 생기는 상황

// Controller
public void controllerMethod() {
    serviceA.save();     // @Transactional - 커밋 완료 ✅
    serviceB.save();     // @Transactional - 커밋 완료 ✅
    serviceC.doSomething(); // @Transactional 없음

    // 💥 여기서 예외 발생!!
}
serviceA → 이미 커밋됨, 롤백 ❌ 불가
serviceB → 이미 커밋됨, 롤백 ❌ 불가
serviceC → 트랜잭션 없으니 롤백 개념 자체가 없음

→ 데이터 불일치 발생! 💀

해결책

이 세 개를 하나의 트랜잭션으로 묶고 싶으면 감싸는 Service를 만들어요.

// Controller
public void controllerMethod() {
    wrapperService.doAll(); // 여기만 호출
}

// WrapperService (또는 기존 Service 중 하나에 합치기)
@Transactional // 얘가 트랜잭션 시작
public void doAll() {
    serviceA.save();        // 같은 트랜잭션 참여
    serviceB.save();        // 같은 트랜잭션 참여
    serviceC.doSomething(); // 같은 트랜잭션 참여

    // 여기서 예외나면 셋 다 롤백 ✅
}

핵심 정리

상황 동작

Controller @Transactional O 전부 하나로 묶임
Controller @Transactional X Service마다 각자 트랜잭션
중간에 예외 발생 이미 커밋된 건 롤백 불가 💀

여러 Service를 하나의 작업단위로 묶어야 한다면, 반드시 상위에 @Transactional이 있는 레이어가 하나 있어야 해요.

728x90
반응형
728x90
반응형

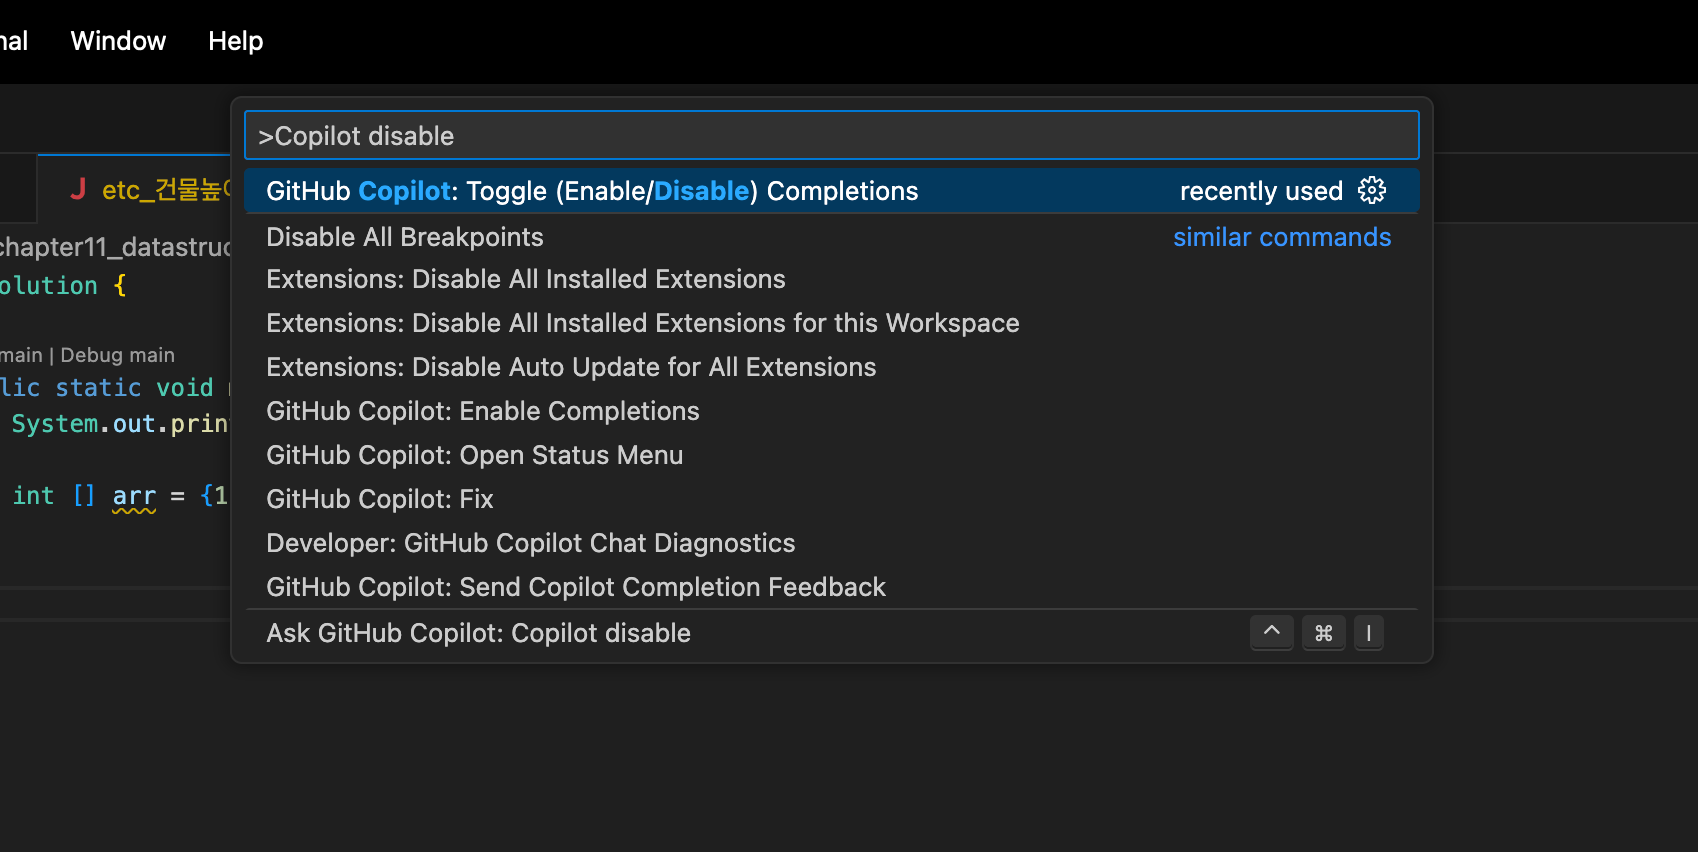
아이콘을 눌러서 끄면 된다는데 제 vscode에는 눈을 씻고 찾아봐도 코파일럿 아이콘이 안보인다...!

이럴때 끄는 방법은 아래...


명령 팔레트로 직접 끄기 (아이콘 없이 끄는 법)

1. [Cmd(⌘) + Shift + P]를 누릅니다. (명령 팔레트 실행)
2. 입력창에 [Copilot disable] 이라고 타이핑하세요.
3. 목록에 나오는 [GitHub Copilot: Disable Completions]를 선택하면 즉시 자동완성이 멈춥니다

728x90
반응형
728x90
반응형

1. 중간 연산 (Intermediate Operation)

  • 특징: 연산 결과가 다시 스트림입니다. 그래서 계속 뒤에 .을 찍고 다른 연산을 이어 붙일 수 있어요 (메서드 체이닝).
  • 특징 2: 지연 연산(Lazy)입니다. 최종 연산이 호출되기 전까지는 아무 일도 안 하고 기다립니다.
연산 설명
filter() 조건에 맞는 요소만 골라냄
map() 요소를 다른 형태로 변환함
sorted() 요소들을 정렬함
distinct() 중복을 제거함
limit() 앞에서부터 n개만 자름
peek() 중간 결과 확인 (디버깅용)

2. 최종 연산 (Terminal Operation)

  • 특징: 스트림을 닫고 결과(숫자, 객체, 값 등)를 내놓습니다.
  • 특징 2: 한 번 실행하면 해당 스트림은 재사용할 수 없으며 끝납니다.
연산 설명 결과 타입
count() 요소의 총 개수를 셈 long
collect() 결과를 리스트, 셋 등으로 모음 List, Map
forEach() 각 요소를 출력하거나 처리함 void
anyMatch() 조건에 맞는 게 하나라도 있는지 확인 boolean
allMatch() 모든 요소가 조건을 만족하는지 확인 boolean
reduce() 모든 요소를 하나로 합침 (합계 등) Optional 또는 값

💡 한눈에 보는 요약

  1. 스트림 생성: 반죽과 팥을 준비한다. (Arrays.stream)
  2. 중간 연산: 팥을 넣고, 모양을 잡고, 탄 부분을 깎아낸다. (map, filter)
  • 이때까지는 붕어빵이 완성된 게 아닙니다. 그냥 과정일 뿐이죠.
  1. 최종 연산: 불을 켜서 구워낸 후 접시에 담는다. (count, collect)
  • 드디어 결과물이 나오고 기계는 멈춥니다.

⚠️ 주의할 점

filtermap까지만 쓰고 세미콜론(;)을 찍으면, 자바는 "어? 준비만 하고 요리를 안 하네?" 하고 그냥 넘어가 버립니다.

728x90
반응형
728x90
반응형

다이소 결제 계좌가 왜 다르지?

체크카드 속 숨겨진 '현금IC 결제' 프로세스 분석


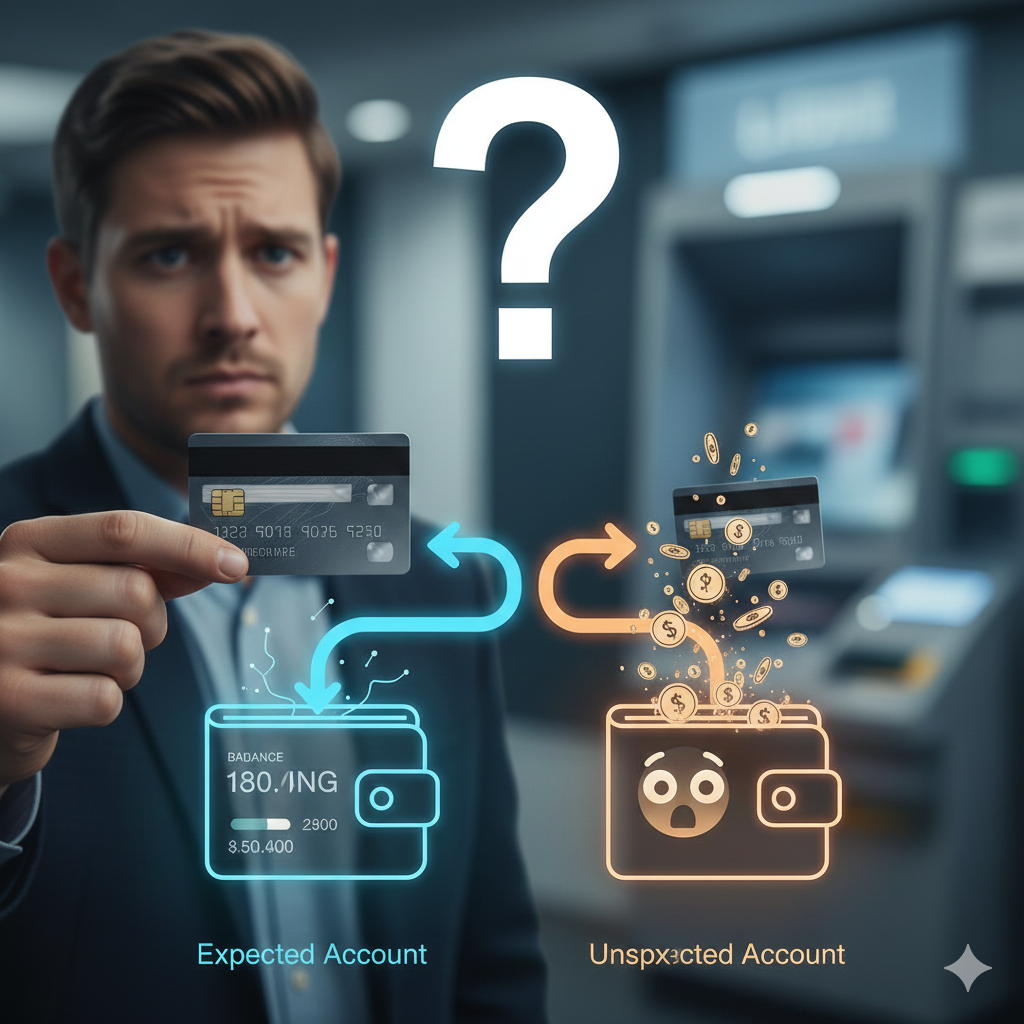
1. 분명 체크카드로 긁었는데, 돈은 딴 계좌에서?

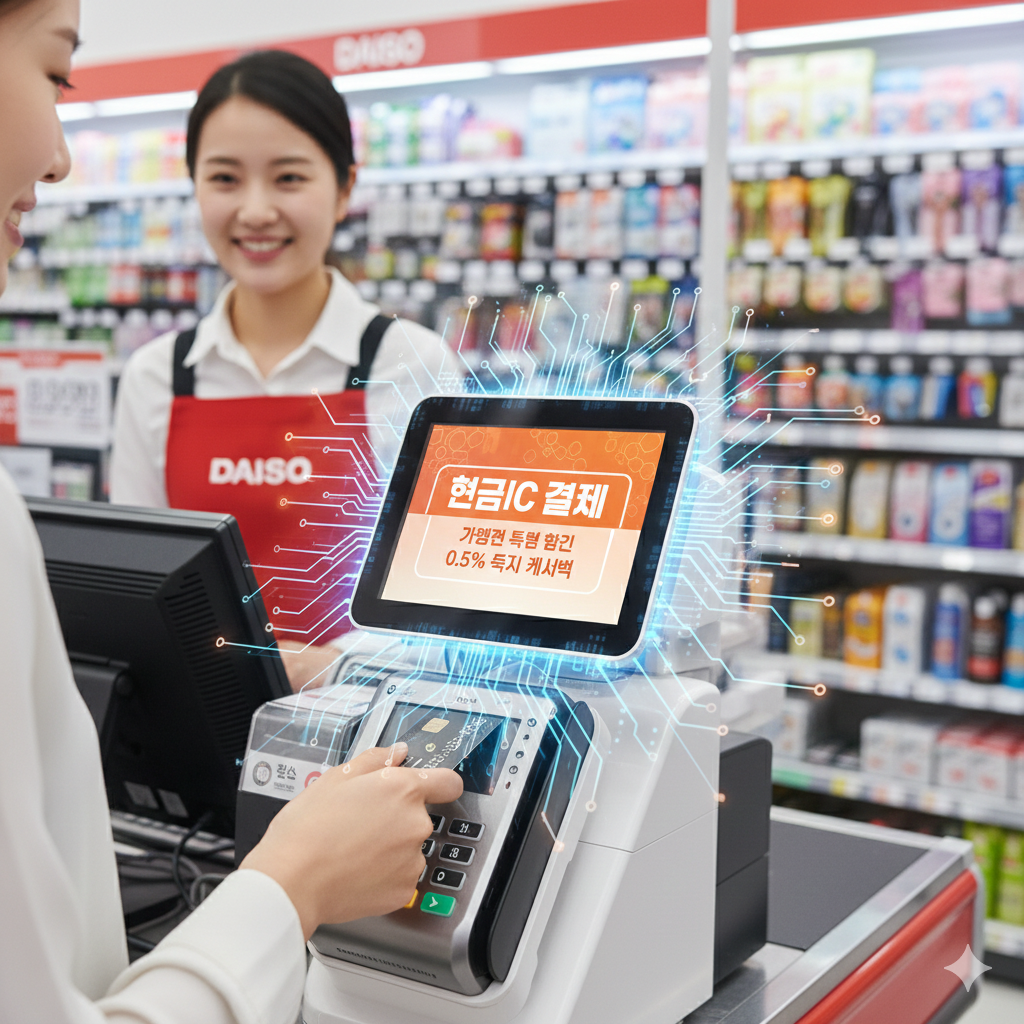
최근 다이소에서 평소 결제 계좌가 아닌, ATM 인출용 계좌에서 잔액이 빠져나가는 당황스러운 경험을 했습니다. 원인은 바로 '현금IC 결제' 방식 때문이었는데요. 이 메커니즘을 IT 관점에서 정리해 봅니다.

2. 가맹점 결제 vs 현금IC 결제의 이원화 방식

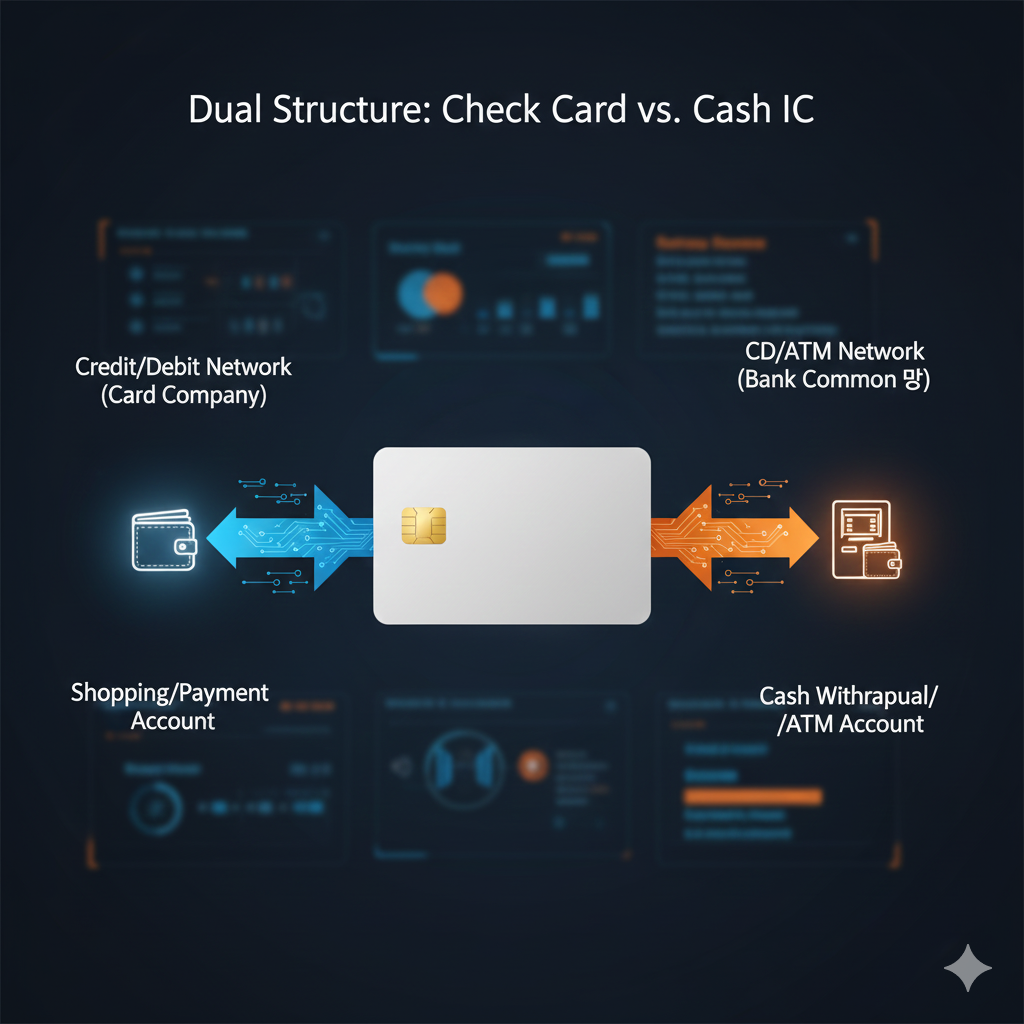
우리가 흔히 쓰는 카드 한 장에는 논리적으로 두 가지 인터페이스가 존재합니다.

* 체크카드(Credit/Debit Network)
카드사 승인망(신한, 국민, 삼성 등)을 경유하여 결제 계좌에서 출금.

* 현금IC(CD/ATM Network)
은행 공동망을 통해 계좌에서 즉시 이체되는 방식. (보통 ATM 인출용으로 설정된 계좌)


대부분의 카드는 이 두 기능의 연결 계좌를 동일하게 설정하지만, 발급 시점에 따라[물건 살 때 계좌][ATM에서 돈 뽑는 계좌]가 별도로 매핑될 수 있습니다.

3. 왜 다이소는 '현금IC 결제'를 선호할까?

다이소 같은 대형 가맹점 단말기에는 현금IC 결제 우선 순위가 설정되어 있는 경우가 많습니다.

* 수수료 절감 : 일반 체크카드 수수료(약 0.5~1.5%)보다 현금IC 결제 수수료가 현저히 낮습니다.

* 빠른 정산 : 카드사를 거치지 않고 은행 간 직접 이체 방식이라 가맹점 입장에서 자금 회전이 유리합니다.

* 사용자 혜택 : 소비자에게는 소득공제 30% 적용 및 결제액의 0.5% 즉시 캐시백 등의 메리트를 제공합니다.

4. IT 종사자가 본 '현금IC 결제'의 특이점

금융 IT 관점에서 볼 때, 이 방식은 결제 프로세스에서 '카드사'라는 미들웨어를 건너뛰고 '은행 코어 뱅킹'에 직접 쿼리를 날리는 것과 유사합니다.

* 계좌 매핑의 경직성 : 일반 체크카드 연결 계좌는 DB 업데이트(영업점 방문)로 쉽게 변경 가능하지만, 현금IC 인출 계좌는 IC 칩 내부 애플릿(Applet)에 바인딩되어 있는 경우가 많아 카드 '재발급'이 필요한 물리적 제약이 존재합니다.

* 우선순위 로직 : 단말기(POS) 소프트웨어에서 IC 칩 내부의 AID(Application ID)를 읽을 때, 체크카드(Debit)보다 현금카드(Cash) 모듈을 우선 호출하도록 설계되어 있습니다.

5. 결론 및 요약

만약 다이소에서 의도치 않은 계좌에서 돈이 나갔다면, 이는 시스템 오류가 아닌 전략적인 결제 경로 선택의 결과입니다.

* 현상 : 체크카드 연결 계좌가 아닌 ATM 인출 계좌에서 결제됨.
* 이유 : 가맹점의 현금IC 결제 우선 순위 설정 때문.
* 해결 : 현금인출 계좌를 바꾸려면 카드 재발급이 필요함. (혹은 결제 시 "체크카드로 해주세요"라고 요청)


금융 IT인으로서 카드 도메인의 복잡성과 IC 칩 내부 로직의 중요성을 다시 한번 체감한 사례였습니다😄

#금융IT #체크카드원리 #현금IC결제 #다이소결제오류 #카드결제계좌 #은행공동망 #금융개발자 #핀테크 #IC칩로직


728x90
반응형
728x90
반응형

케글 대회 코드는 바로 pdf로 다운로드할 수 없다!

ipynb 주피터 노트북 형태로 다운받은 뒤, 아래 사이트에서 pdf로 변환하면 된다


https://www.runcell.dev/tool/jupyter-to-pdf


Ipynb (Jupyter Notebook) to PDF Converter

Free online tool to turn .ipynb notebooks into PDF documents with a live preview. Export notebooks as professional PDFs in seconds without LaTeX.

www.runcell.dev


이 사이트도 로그인 필요없고, 무료라 아주 유용!

마크다운 글자도 안깨지고 아주 잘 변환된다


728x90
반응형
728x90
반응형

LLM에 파일을 학습시켜야 하는데,

하나의 질의에서 업로드 할 수 있는 파일 갯수가 제한되어 있어 pdf를 병합해서 학습시켜야 했다!


이때 유용한 무료 pdf파일 병합 사이트 추천~!

https://www.ilovepdf.com/ko 


iLovePDF | PDF를 즐겨 쓰시는 분들을 위한 온라인 PDF 툴

iLovePDF는 PDF 파일 작업을 위한 온라인 서비스로 완전히 무료이며 사용하기 쉽습니다. PDF 병합, PDF 분리, PDF 압축, 오피스 파일에서 PDF로, PDF에서 JPG로 변환 등!

www.ilovepdf.com


로그인하고 메일주소 등록하고 이런 귀찮은 절차 없이도 

무료로 사용 가능해서 아주 유용하다!


728x90
반응형
728x90
반응형

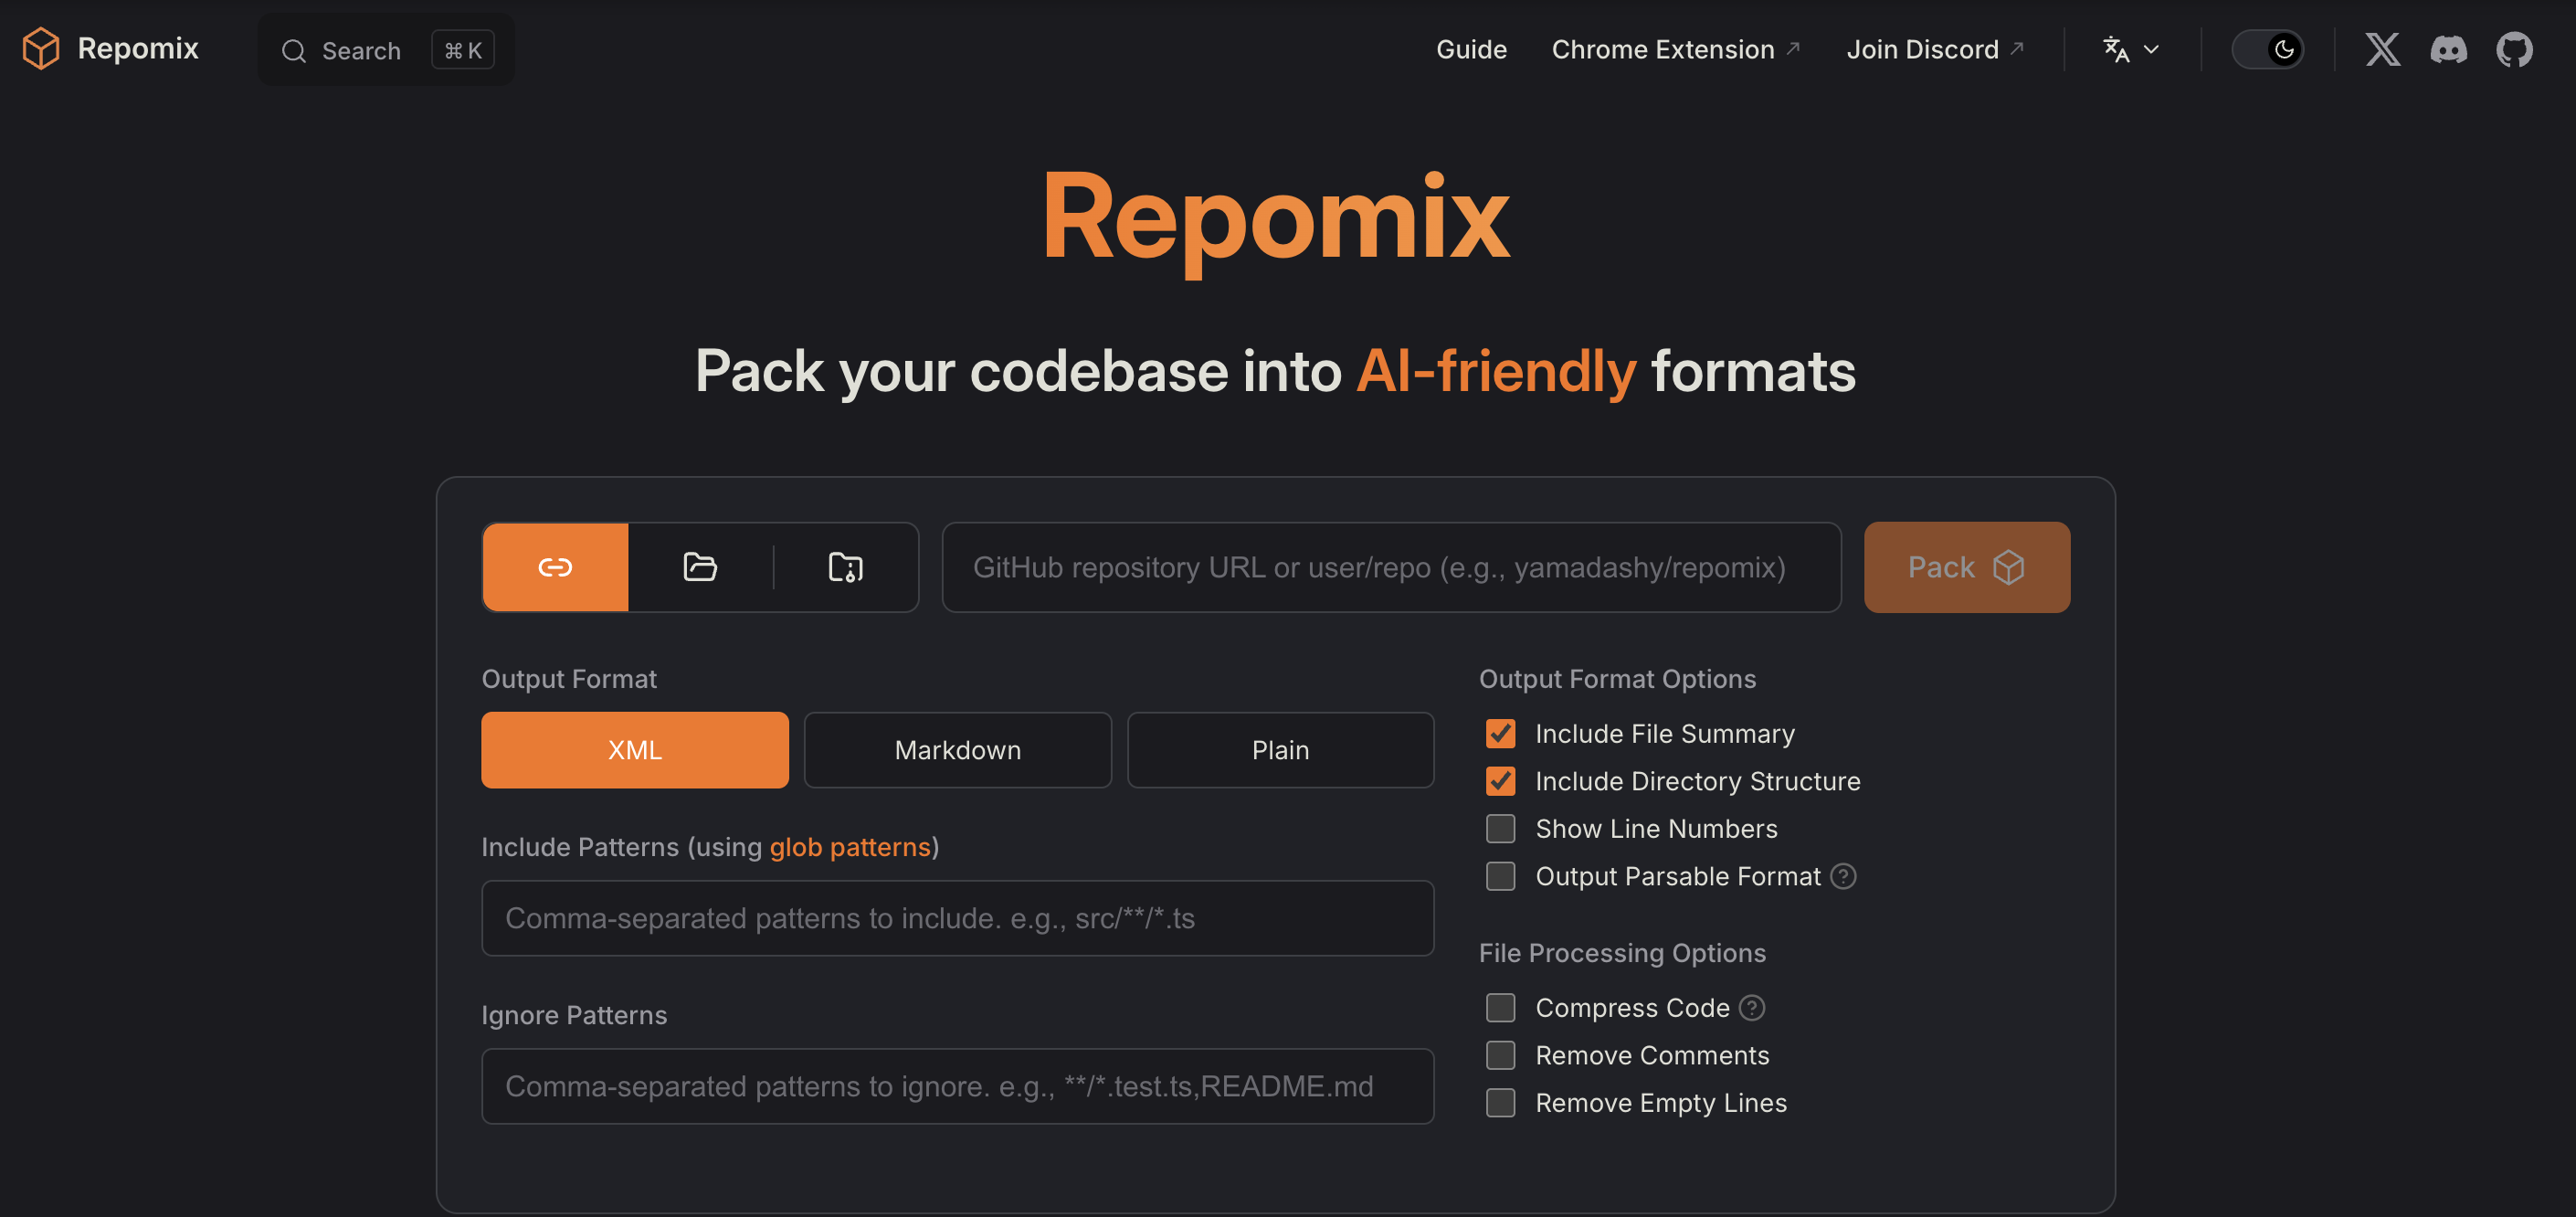
✅ Repomix란 무엇일까?

  • Repomix코드베이스 전체를 AI 모델이 이해하기 쉬운 단일 파일(XML, 마크다운, TXT 등)로 압축해 주는 도구입니다.
  • 주로 ChatGPT, Claude, Gemini와 같은 LLM(대규모 언어 모델)이나 다른 AI 도구에 코드베이스 전체 컨텍스트를 제공할 때 유용합니다.

🔗 Repomix 관련 주소

  • 공식 웹사이트 (가장 자세한 정보) : https://repomix.com/
  • 대표적인 GitHub 저장소 (CLI 도구 관련) : https://github.com/yamadashy/repomix
    • 위 GitHub 저장소는 Repomix의 CLI (Command Line Interface) 도구와 관련된 정보를 제공합니다.
    • 로컬에서 프라이빗 리포지토리를 처리하거나 더 세부적인 설정이 필요할 때 CLI를 사용하면 유용합니다.

🔍 Repomix 주요 특징

  • AI 친화적 형식으로 변환 : 코드베이스를 AI가 쉽게 이해하고 처리할 수 있도록 최적화된 형식으로 패키징합니다.
  • 단일 파일 압축 : 전체 리포지토리를 하나의 파일로 만들어 LLM의 컨텍스트 창에 쉽게 넣을 수 있습니다.
  • .gitignore 자동 인식 : 불필요하거나 제외해야 할 파일은 자동으로 반영하여 압축에서 제외합니다.
  • 민감 정보 검사 (Secretlint) : 코드에 API 키나 자격 증명 같은 민감 정보가 포함되어 있는지 확인하고, 필요 시 해당 파일을 제외하여 보안을 강화합니다.
  • 토큰 수 계산 : 각 파일과 전체 코드베이스의 토큰 수를 제공하여 LLM의 컨텍스트 제한을 관리하는 데 도움을 줍니다.
  • 다양한 출력 형식 : XML, 마크다운, 일반 텍스트 등 다양한 형식으로 출력할 수 있습니다.

🔒 Private GitHub 리포지토리 활용

  • Repomix 웹사이트 버전은 일반적으로 공개 리포지토리만 지원하며, 프라이빗 리포지토리는 CLI를 사용할 것을 권장합니다.
    • CLI (Command Line Interface) 버전 사용 : Repomix의 CLI 버전은 사용자의 로컬 머신에서 모든 코드를 처리하기 때문에, 코드가 외부 서버나 클라우드로 전송되지 않습니다.
    • 로컬 처리 : 프라이빗 리포지토리를 로컬에 클론(clone)한 후 Repomix CLI를 실행하면, 안전하게 코드베이스를 AI 친화적 파일로 변환할 수 있습니다.

결론

Repomix를 사용하면 프라이빗 프로젝트의 코드를 LLM에 제공하여 코드 검토, 리팩토링, 기능 구현, 테스트 코드 생성 등 다양한 AI 지원 작업을 안전하게 수행할 수 있습니다.

728x90
반응형
728x90
반응형

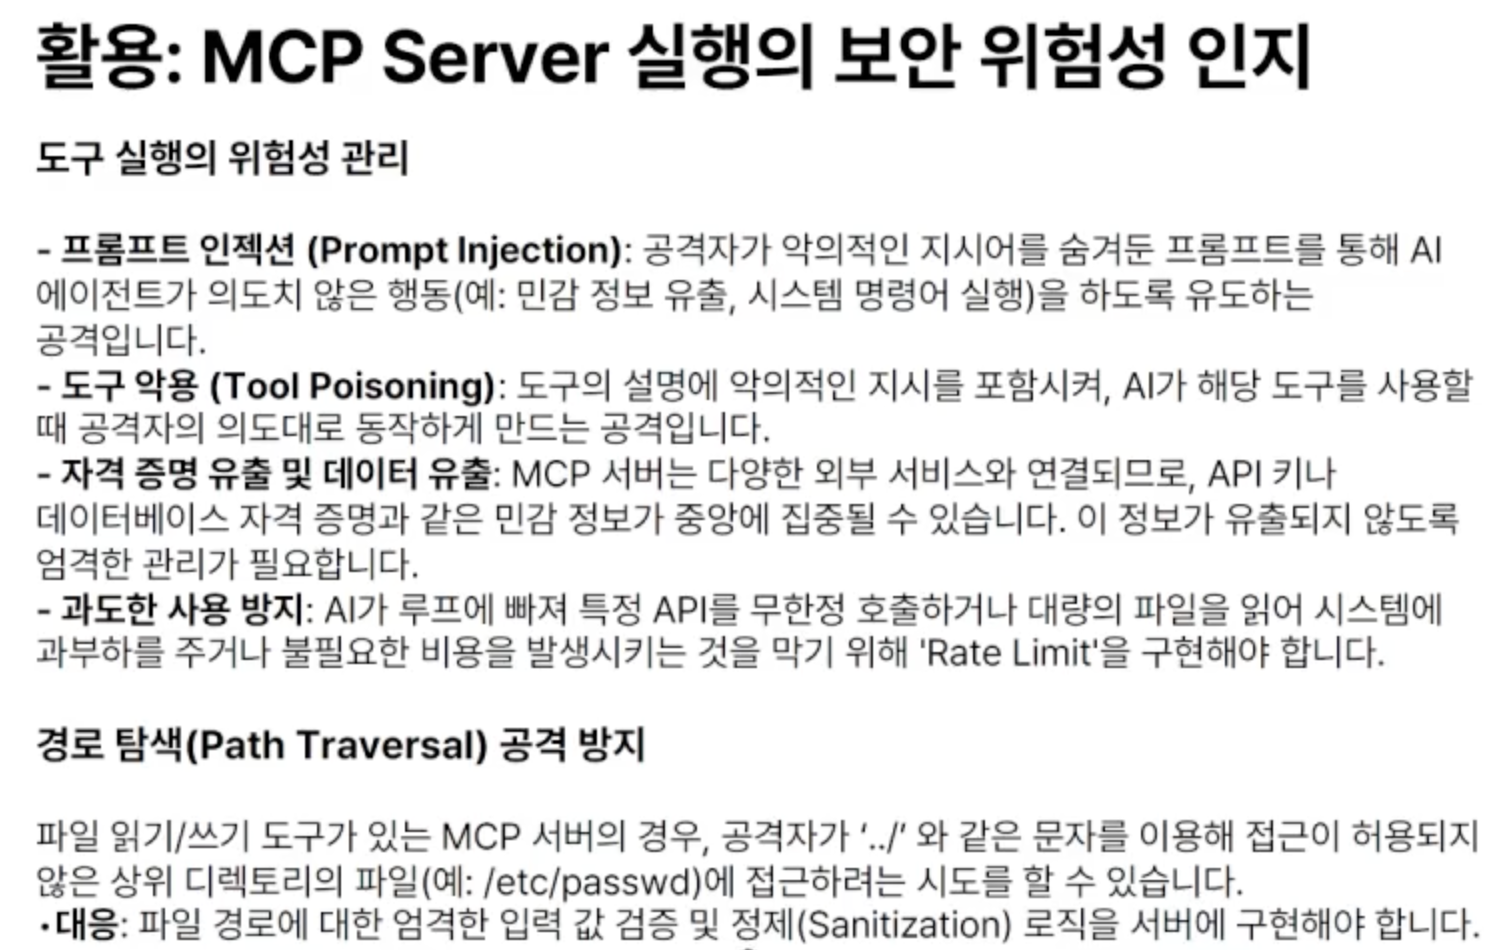
🧐 MCP와 세션 ID 보안 문제의 연관성

  • MCP : AI 에이전트가 여러 도구를 사용하고, 복잡한 작업을 수행할 때 필요한 구조화된 호출을 위한 아키텍처
  • 이때 MCP 환경에서 세션 ID를 '인증 수단'으로 이용하면 안되는 이유는 다음과 같습니다.

1. 세션 하이재킹 (Session Hijacking) 및 탈취 위험

  • 세션 ID 자체가 인증 정보를 담고 있고, 이 ID 하나로 모든 대화권한이 유지되므로,
  • 공격자가 세션 ID를 탈취하면 사용자의 모든 권한을 획득할 수 있습니다.
    • 취약점의 핵심 : 세션 ID가 탈취되었을 때, 이를 통해 대화 내용뿐만 아니라 해당 세션으로 접근 가능한 모든 자원과 기능을 악용할 수 있습니다.
  • 세션 ID가 긴 대화(세션) 동안 고정되어 사용되기 때문에, 탈취 기회가 길어지고 노출 위험이 커집니다.
    • '모든 대화 내용이 유출될 위험'이 있으며, 더 나아가 사용자 권한의 오용으로 이어집니다.

2. MCP 환경의 특수성 (인증 표준 및 컨텍스트 암호화 부재)

  • MCP는 설계상 인증 표준이나 컨텍스트(대화 내용)암호화가 부족할 수 있습니다.
  • 이러한 환경에서 민감한 정보를 포함하는 긴 컨텍스트(대션)를 단순한 세션 ID 하나로만 보호한다면, 보안 정책이 쉽게 우회될 수 있습니다.

3. MCP '인증 표준 부재'의 의미

  • 일반 웹 환경
    • 로그인은 OAuth, SAML 등 엄격한 인증 표준을 따르며, 통신은 TLS/SSL(HTTPS)암호화되는 것이 기본입니다.
  • MCP 환경의 잠재적 문제
    • MCP는 원래 '쉬운 통합''통일된 인터페이스'를 우선시하여 설계되는 경향이 있습니다.
    • 따라서 AI 에이전트와 각 외부 도구(예: 이메일 발송 도구, 데이터베이스 조회 도구) 간의 내부 통신에서는 다음과 같은 문제가 발생할 수 있습니다.
      • 인증 표준 없음: 각 도구 호출마다 사용자 권한을 재검증하는 엄격한 표준이 없을 수 있습니다.
      • 컨텍스트 암호화 없음: 에이전트가 도구에 전달하는 대화의 맥락이나 민감한 정보(컨텍스트)가 내부망에서 암호화되지 않은 채 평문으로 전달될 수 있습니다.

4. '긴 컨텍스트'와 '단순 세션 ID'의 위험

AI 에이전트와의 대화는 일반적인 웹 요청과 달리 하나의 세션 ID 아래에서 수많은 단계와 민감한 정보를 주고받습니다.

  • 긴 컨텍스트(대화 내용)
    • MCP에서는 "1. 재고를 조회하고, 2. 고객 정보를 확인한 뒤, 3. 결제를 승인해 줘"와 같이
    • 여러 단계의 민감한 정보가 하나의 대화 맥락 안에 담깁니다.
  • 단순 세션 ID로 보호
    • 이 모든 민감한 정보와 권한을 오직 세션 ID라는 열쇠 하나로만 보호한다는 뜻입니다.
    • 이 세션 ID가 탈취되면, 공격자는 마치 사용자 본인인 것처럼 에이전트에게 모든 도구 호출 권한을 행사할 수 있습니다.

5. '보안 정책 우회'가 발생하는 이유

세션 ID가 탈취되는 순간, 모든 보안 검증이 무력화됩니다.

  • 공격자가 탈취한 세션 ID를 사용하여 에이전트에게 요청을 보냅니다.
  • 에이전트와 도구는 이 세션 ID를 '정상적인 사용자'의 것으로 간주하고, 추가적인 인증이나 권한 검증 없이 요청을 처리합니다.
  • 결과
    • 에이전트는 공격자의 지시에 따라 재고 조회, 고객 정보 확인, 심지어 결제 승인과 같은 민감한 행동을 정상적인 작업으로 수행하게 됩니다.
    • 이는 시스템이 의도한 모든 보안 정책과 실행 정책이 우회되는 결과를 낳습니다.

6. 참고

결론 : MCP 보안에서 세션을 인증 수단으로 이용하면 안되는 이유

  • 세션 ID 하나에 대화가 계속 이어지는 구조의 특성 상 때문입니다.
  • 이러한 구조에서 세션 ID 탈취 시 민감한 모든 대화 내용 유출은 물론, 해당 세션으로 보장되는 모든 권한의 오용이라는 심각한 위험을 내포하고 있습니다.
  • 이는 특히 MCP와 같이 복잡한 작업과 컨텍스트를 다루는 환경에서 치명적인 보안 문제가 됩니다.


728x90
반응형

+ Recent posts